熊出沒警報地圖:用 Leaflet 把 846 筆通報變成看得懂的地圖
2025年11月7日
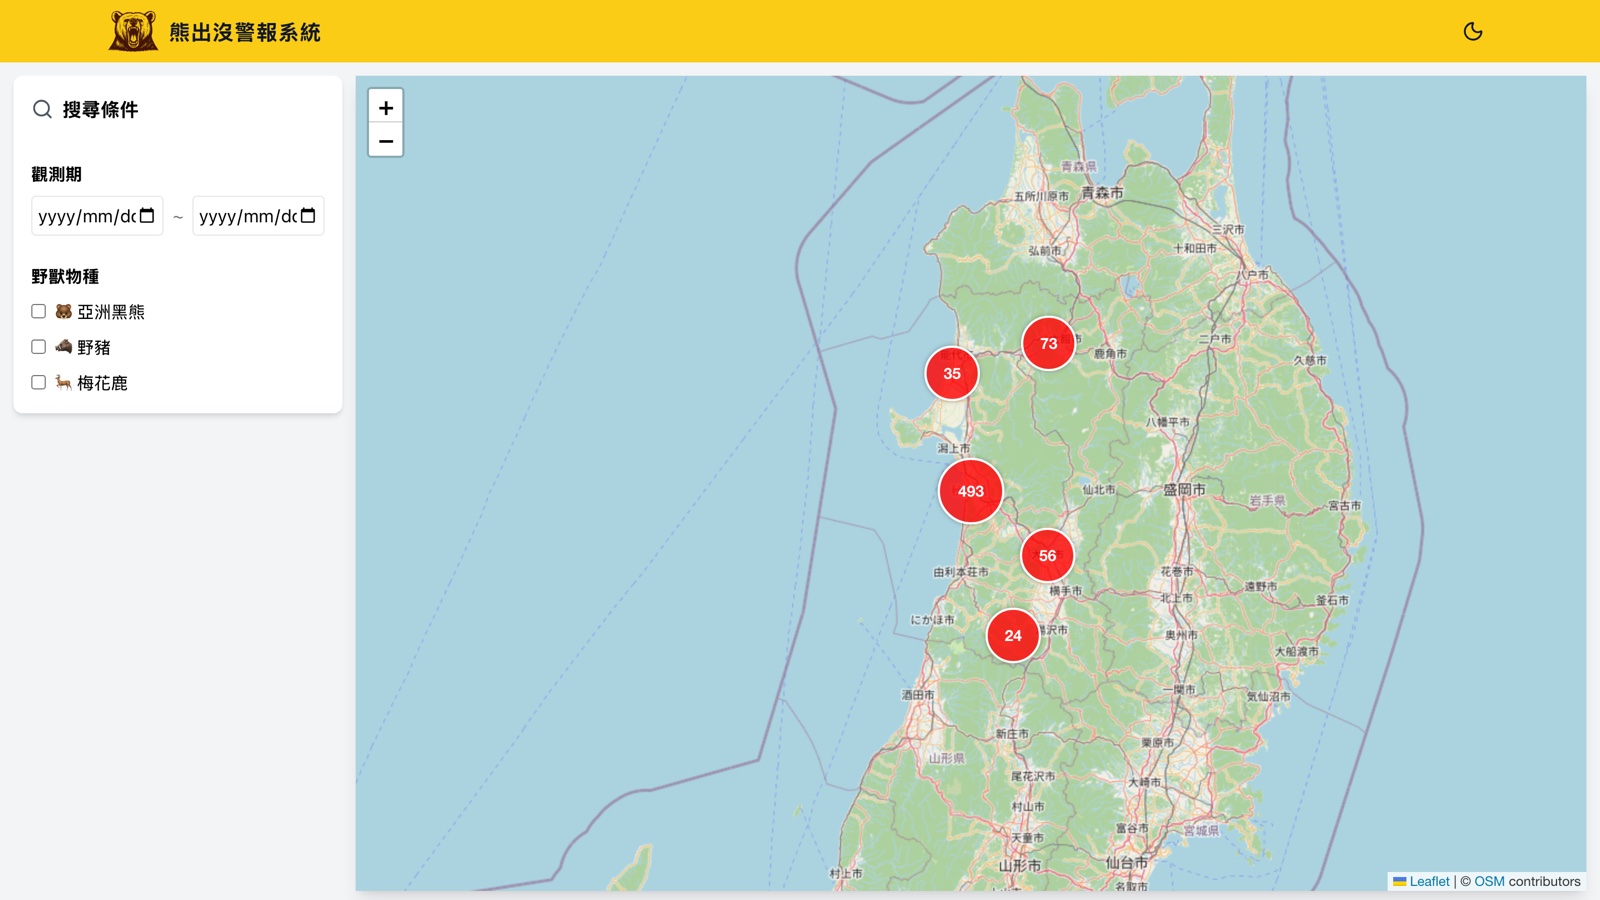
為什麼做這個專案
2025 年秋天,日本東北地區的熊出沒事件大幅增加,新聞幾乎每天都有目擊與傷人的消息。看著一則則文字報導,很難想像「到底有多密集、集中在哪裡」。於是花了幾天時間,把這些通報資料放到地圖上,讓分布一眼就能看懂。
這次整理的資料涵蓋 2025/11/02~11/05 共 846 筆通報,其中 743 筆位於秋田縣。物種以亞洲黑熊(ツキノワグマ)為大宗,共 835 筆;另有少量野豬與日本鹿。通報類型包含目擊、痕跡、食害,以及 4 起人身傷害。
技術架構
| 項目 | 使用技術 |
|---|---|
| 框架 | Next.js 16(App Router)+ TypeScript |
| 地圖 | Leaflet + react-leaflet,底圖使用 OpenStreetMap |
| 標記聚合 | react-leaflet-cluster |
| 狀態管理 | Zustand |
| 動畫 | Framer Motion |
| 樣式 | Tailwind CSS,支援深色模式 |
| 部署 | Vercel |
資料以靜態 JSON 載入,每筆包含時間、通報類型、城市、地址、物種、數量、描述與經緯度。
主要功能
標記聚合:讓 846 個點不再擠成一團
846 個標記直接畫在地圖上會完全重疊,看不出任何資訊。這裡用 react-leaflet-cluster 依縮放層級自動聚合,並自訂聚合圓圈的樣式:數量越多,圓圈越大。
iconCreateFunction={(cluster) => {
  const count = cluster.getChildCount();
  const size = count < 10 ? 40 : count < 100 ? 50 : 60;
  return L.divIcon({
    html: `<div class="cluster">${count}</div>`,
    iconSize: [size, size],
  });
}}
縮小時看得到整體熱區,放大後才展開成單一事件,閱讀的層次就出來了。
同一地址的點:加一點隨機偏移
不少通報的經緯度完全相同(同一個村落、同一條路),即使放大到最大也會疊在一起點不到。解法是在渲染時加上極小的隨機偏移(jitter),讓重疊的點稍微散開,又不影響對位置的判讀。
物種圖示與事件細節
熊、野豬、鹿各有不同圖示。點擊標記會跳出卡片,顯示時間、城市、地址、數量和現場描述。
篩選:日期區間與物種
左側面板可以設定觀測期間,以及勾選要顯示的物種。篩選狀態放在 Zustand store 裡,地圖只負責讀取篩選後的結果。
原始資料的物種名稱是日文,介面則顯示中文,所以篩選時做了一層中日對照:
(sp === "亞洲黑熊" && s.species?.includes("ツキノワグマ")) ||
(sp === "野豬" && s.species?.includes("イノシシ")) ||
(sp === "梅花鹿" && s.species?.includes("シカ"))
在手機上,篩選面板可以收合,把畫面留給地圖。
部署時踩到的坑
本機開發一切正常,推上 Vercel 卻連續 build 失敗。原因都出在 TypeScript 型別檢查:
- JSON 裡的
id、count、經緯度,有的是字串、有的是數字,型別定義太嚴格就會報錯,最後放寬成string | number - Leaflet 的型別套件
@types/leaflet沒裝,本機有快取所以沒發現 react-leaflet-cluster的iconCreateFunction參數型別對不上
教訓是:推上去之前,先在本機跑一次 next build。next dev 不做完整的型別檢查,很多錯誤只會在 production build 才出現。
小結
這是一個規模不大、但很完整的資訊視覺化練習:把一堆文字通報,轉換成可以縮放、篩選、點擊查看的地圖。過程中最有感的是,資料量一大,「怎麼呈現」比「能不能呈現」更重要:聚合、偏移、篩選,都是為了讓人看得懂。